2023年深度學習電腦服務器/工作站配置方案(一期) 從入門到企業(yè)級
隨著深度學習模型規(guī)模的爆炸式增長,2023年對硬件的要求達到了新的高度。無論是個人研究者、小型實驗室還是企業(yè)團隊,選擇合適的服務器或工作站成為項目成敗的關鍵。本文作為系列第一期,將針對不同預算和應用場景,提供四套經過實踐驗證的配置方案。
核心選型原則
在深入配置單前,需明確深度學習的四大硬件瓶頸:顯存容量、GPU間通信帶寬、CPU-GPU數(shù)據(jù)吞吐、存儲IO。2023年的主流選擇依然圍繞NVIDIA生態(tài),AMD Instinct系列雖在特定場景有性價比,但CUDA的不可替代性讓NVIDIA GPU成為首選。
關鍵教訓:顯存為王。訓練大語言模型(LLM)或高分辨率視覺模型時,單卡24GB顯存僅是入場券。模型并行與數(shù)據(jù)并行需要NVLink或至少PCIe 4.0 x16的高帶寬互聯(lián)。
方案一:個人研究入門工作站(預算2 - 3萬元)
目標用戶:學生、個人開發(fā)者,學習CV/NLP基礎模型,迷你數(shù)據(jù)集訓練或微調。
- GPU:NVIDIA RTX 4090 24GB(1塊)—— 消費級旗艦,F(xiàn)P16算力與3090 Ti相當,顯存足夠微調7B參數(shù)以下模型。
- CPU:Intel Core i7-13700K 或 AMD Ryzen 9 7900X —— 16核以上,保證數(shù)據(jù)預處理不拖后腿。
- 主板:Z790 或 B650(需支持PCIe 5.0,為未來升級預留)。
- 內存:64GB DDR5 5200MHz(2x32GB)—— 入門夠用,若數(shù)據(jù)集大建議128GB。
- 存儲:1TB PCIe 4.0 NVMe SSD(系統(tǒng)+代碼)+ 2TB PCIe 3.0 NVMe SSD(數(shù)據(jù)集)。
- 電源:1000W 80Plus金牌 —— 4090瞬時功耗高,余量要足。
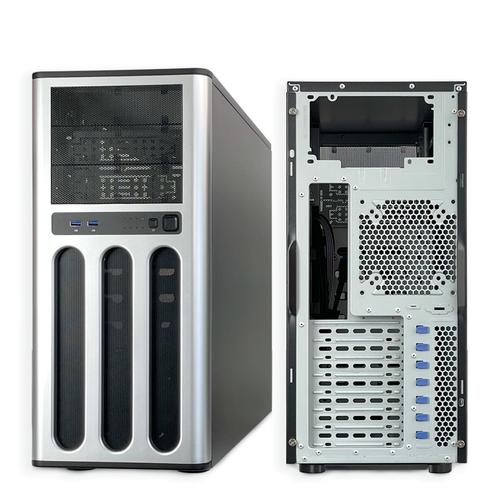
- 機箱:中塔風道優(yōu)秀款,如Fractal Design Torrent。
- 散熱:360一體式水冷 + 機箱風扇。
此方案適合個人書房,噪音可控。缺點是單卡顯存有限,無法訓練ViT-Large以上的模型或全參數(shù)微調70B模型(可QLoRA)。
方案二:進階多卡工作站(預算8 - 12萬元)
目標用戶:小型實驗室、初創(chuàng)團隊,中等規(guī)模訓練或高吞吐推理。
- GPU:NVIDIA RTX 6000 Ada 48GB(1-2塊)—— 專業(yè)卡,48GB顯存可微調13B模型或以較大batch訓練。2塊通過NVLink橋接,顯存疊加至96GB,適合70B模型的QLoRA。
- CPU:AMD Threadripper PRO 5955WX(16核)或 Intel Xeon W-3400系列 —— 提供128條PCIe通道,支持多卡全速運行。
- 主板:WRX80 或 W790 芯片組工作站主板。
- 內存:256GB DDR4 ECC RDIMM(8x32GB)—— ECC確保長時間訓練不因內存錯誤崩潰。
- 存儲:2TB PCIe 4.0 NVMe SSD(系統(tǒng))+ 4TB PCIe 4.0 NVMe SSD(數(shù)據(jù)集/檢查點)+ 8TB SATA SSD(歸檔)。
- 電源:1600W 80Plus鉑金(若雙卡或更高,建議2000W)。
- 機箱:全塔如Corsair 7000D,支持多GPU風道。
- 散熱:CPU 360水冷,GPU渦輪散熱或改水冷。
優(yōu)點:專業(yè)卡驅動與ECC內存保障7x24穩(wěn)定性,NVLink大幅提升多卡通信效率。缺點:成本較高,但相比A100整機仍具性價比。
方案三:企業(yè)級訓練服務器(預算30 - 50萬元)
目標用戶:中大型企業(yè)AI團隊,訓練百億參數(shù)以內模型,或作為推理集群節(jié)點。
- GPU:NVIDIA A100 80GB PCIe或SXM(4塊)—— 2023年性價比更高的是A100 80GB,若追求新架構可考慮H100,但供貨不穩(wěn)。4塊A100通過NVSwitch或NVLink Bridge實現(xiàn)600GB/s互聯(lián)。
- CPU:雙路 AMD EPYC 9354(32核/顆)或 Intel Xeon Platinum 8480+ —— 提供128核以上,避免數(shù)據(jù)加載瓶頸。
- 主板:支持雙路CPU及4 - 8 GPU的服務器主板,如Supermicro H13系列。
- 內存:1TB DDR5 ECC(16x64GB)—— 滿足數(shù)據(jù)預處理緩存的容量。
- 存儲:2TB NVMe RAID1(系統(tǒng))+ 8TB NVMe RAID0(高速緩存)+ 50TB HDD RAID5(數(shù)據(jù)集)。
- 網絡:InfiniBand HDR 200Gbps 或 雙口100G以太網—— 多機擴展必需。
- 電源:4x 2000W鈦金冗余電源。
- 機箱:4U機架式,支持8 GPU(當前裝4塊預留升級)。
- 散熱:服務器風冷,整機風道經過CFD優(yōu)化。
此配置可輕松訓練GPT-3級別的百億參數(shù)模型(需模型并行)。注意:A100 40GB已停產建議直接上80GB版。InfiniBand交換機成本還需單列,約5 - 10萬元。
方案四:極致性能科研平臺(預算100萬元以上)
目標用戶:前沿AI實驗室,訓練千億參數(shù)大模型。核心組件:8x NVIDIA H100 SXM 80GB(通過NVLink Switch互聯(lián),顯存池640GB)、雙路AMD EPYC 9654(96核/顆)、2TB DDR5內存、100TB NVMe全閃存陣列、NDR InfiniBand 400G網絡。整套需配套液冷或增強風冷機架,CPU+GPU總功耗近10kW。
不建議個人或小團隊自建此類系統(tǒng),可考慮AWS、Azure的H100實例按需租用,或與超算中心合作。
通用配件與調優(yōu)建議
- 電源:每塊GPU預留300 - 500W預算,例如4090峰值450W,A100 300W但瞬時可達400W。
- CPU:密集數(shù)據(jù)管道作業(yè)需32核以上,一般訓練16核夠用。別忘了PCIe通道數(shù),多卡時至少每卡x8。
- Linux發(fā)行版:Ubuntu 22.04 LTS + NVIDIA驅動535/CUDA 12.2是2023最穩(wěn)組合。
- 框架編譯技巧:每次換卡安裝NCCL與PyTorch時指定正確架構,例如4090設為sm89,A100為sm80。
- 散熱監(jiān)控:使用nvidia-smi dmon實時監(jiān)控溫度與功耗,建議壓力測試(如用stable diffusion批量出圖)跑通宵后驗收。
與下期預告
一期方案覆蓋了從2萬元到百萬元的配置思路。實戰(zhàn)中仍需結合自己的模型大小與并行策略靈活調整,比如僅微調實驗可省下CPU與存儲預算全力堆GPU。下一期將聚焦二手礦卡與國產GPU的折騰方案,以及如何利用QUADRO/RTX混合組隊降低顯存壓力。敬請關注。
最新產品